- Dla kogo
- Firma, w której pracownicy ciągle pytają o to samo: procedury, cenniki, warunki umów, instrukcje
- Jak działa
- Wyszukuje w Twoich dokumentach pasujące fragmenty i dopiero na ich podstawie model AI pisze odpowiedź ze źródłem
- Koszt API
- Zwykle drobna część budżetu. Więcej kosztuje porządek w dokumentach, budowa i utrzymanie
- Czas wdrożenia
- Pilotaż na jednym obszarze: zwykle kilka tygodni, z czego większość to przygotowanie dokumentów i testy
Szybka odpowiedź
Firmowy asystent AI na własnych dokumentach działa w modelu RAG: dokumenty są dzielone na fragmenty i zapisywane w bazie wektorowej, a przy każdym pytaniu system wyszukuje kilka najbardziej pasujących fragmentów i przekazuje je modelowi językowemu razem z pytaniem. Model odpowiada na ich podstawie i podaje źródło. Koszt API przy kilku tysiącach pytań miesięcznie to w przykładzie obliczeniowym od kilku do kilkuset dolarów, zależnie od modelu (stan cennika na 10 listopada 2026). Główne koszty to przygotowanie dokumentów, budowa przepływu i utrzymanie.
Właściciele firm pytają mnie coraz częściej o to samo: „Czy da się zrobić ChatGPT, który zna nasze procedury?”. Da się, ale nie przez „nauczenie” modelu Twoich dokumentów. Model się nie zmienia. Zmienia się to, co dostaje do przeczytania przy każdym pytaniu.
Poniżej wyjaśniam, jak taki asystent działa, co musisz przygotować po stronie firmy, jak go zbudować krok po kroku i od czego zależy koszt. Ceny API podaję według oficjalnego cennika OpenAI, stan na 10 listopada 2026. Jeśli dopiero zaczynasz z AI w firmie, najpierw przeczytaj plan wdrożenia AI w firmie na 30 dni. Asystent na dokumentach to zwykle drugi albo trzeci krok, a nie pierwszy.
Czym asystent na dokumentach różni się od zwykłego ChatGPT
Zwykły czat odpowiada z wiedzy ogólnej, którą model zdobył podczas trenowania. Nie zna Twojego cennika, wewnętrznej procedury reklamacji ani warunków umowy z największym klientem. Jeśli pracownik wklei dokument do czatu, model go przeczyta, ale tylko w tej jednej rozmowie i tylko ten jeden plik.
Asystent na dokumentach robi trzy rzeczy inaczej:
- Sam szuka w całej bazie. Pracownik nie musi wiedzieć, w którym pliku jest odpowiedź.
- Odpowiada tylko na podstawie znalezionych fragmentów. Dobrze ustawiony mówi „nie znalazłem tego w dokumentach”, zamiast zgadywać.
- Podaje źródło. Nazwę dokumentu, a czasem rozdział, żeby człowiek mógł sprawdzić.
Do prostych zastosowań wystarczą gotowe funkcje planów firmowych, np. projekty z plikami w ChatGPT czy podobne funkcje w Copilot i Gemini. Porównuję je we wpisie ChatGPT, Copilot czy Gemini dla firmy. Własny asystent ma sens, gdy dokumentów jest dużo, często się zmieniają, mają być pobierane automatycznie z dysku firmowego, a odpowiedzi mają trafiać tam, gdzie pracują ludzie: do komunikatora, panelu firmowego albo na stronę.
Jak działa RAG prostym językiem
RAG to skrót od retrieval-augmented generation, czyli generowanie odpowiedzi wspomagane wyszukiwaniem. Całość składa się z dwóch przepływów. Pierwszy przygotowuje wiedzę i działa w tle, np. co noc. Drugi uruchamia się przy każdym pytaniu.
Kilka pojęć, które usłyszysz od wykonawcy:
- Fragment (chunk) – kawałek dokumentu, zwykle od kilku zdań do kilku akapitów. Dokumentacja n8n podaje, że małe fragmenty, rzędu 200–500 tokenów, sprawdzają się przy precyzyjnym wyszukiwaniu, a zbyt duże „rozmywają” znaczenie (RAG w dokumentacji n8n).
- Embeddings – zamiana tekstu na ciąg liczb, w którym teksty o podobnym znaczeniu leżą blisko siebie. Dzięki temu pytanie „ile mamy na zwrot” znajdzie akapit o „terminie odstąpienia od umowy”.
- Baza wektorowa – baza, która przechowuje te liczby i szybko znajduje najbliższe. Może to być osobna usługa albo rozszerzenie bazy PostgreSQL.
- Token – jednostka, w której liczy się tekst i koszt. W języku polskim jedno słowo to często więcej niż jeden token.
Jak to wygląda w praktyce
Poniżej przepływ zbudowany w n8n. Górna część to czat dla pracowników: wiadomość trafia do węzła „Asystent firmowy”, który ma podłączony model czatu, pamięć rozmowy i narzędzie „Baza wiedzy”. Dolna część uruchamia się co noc o 2:00, pobiera dokumenty z Dysku Google, wczytuje pliki PDF i DOCX, dzieli je na fragmenty i zapisuje w bazie wiedzy.
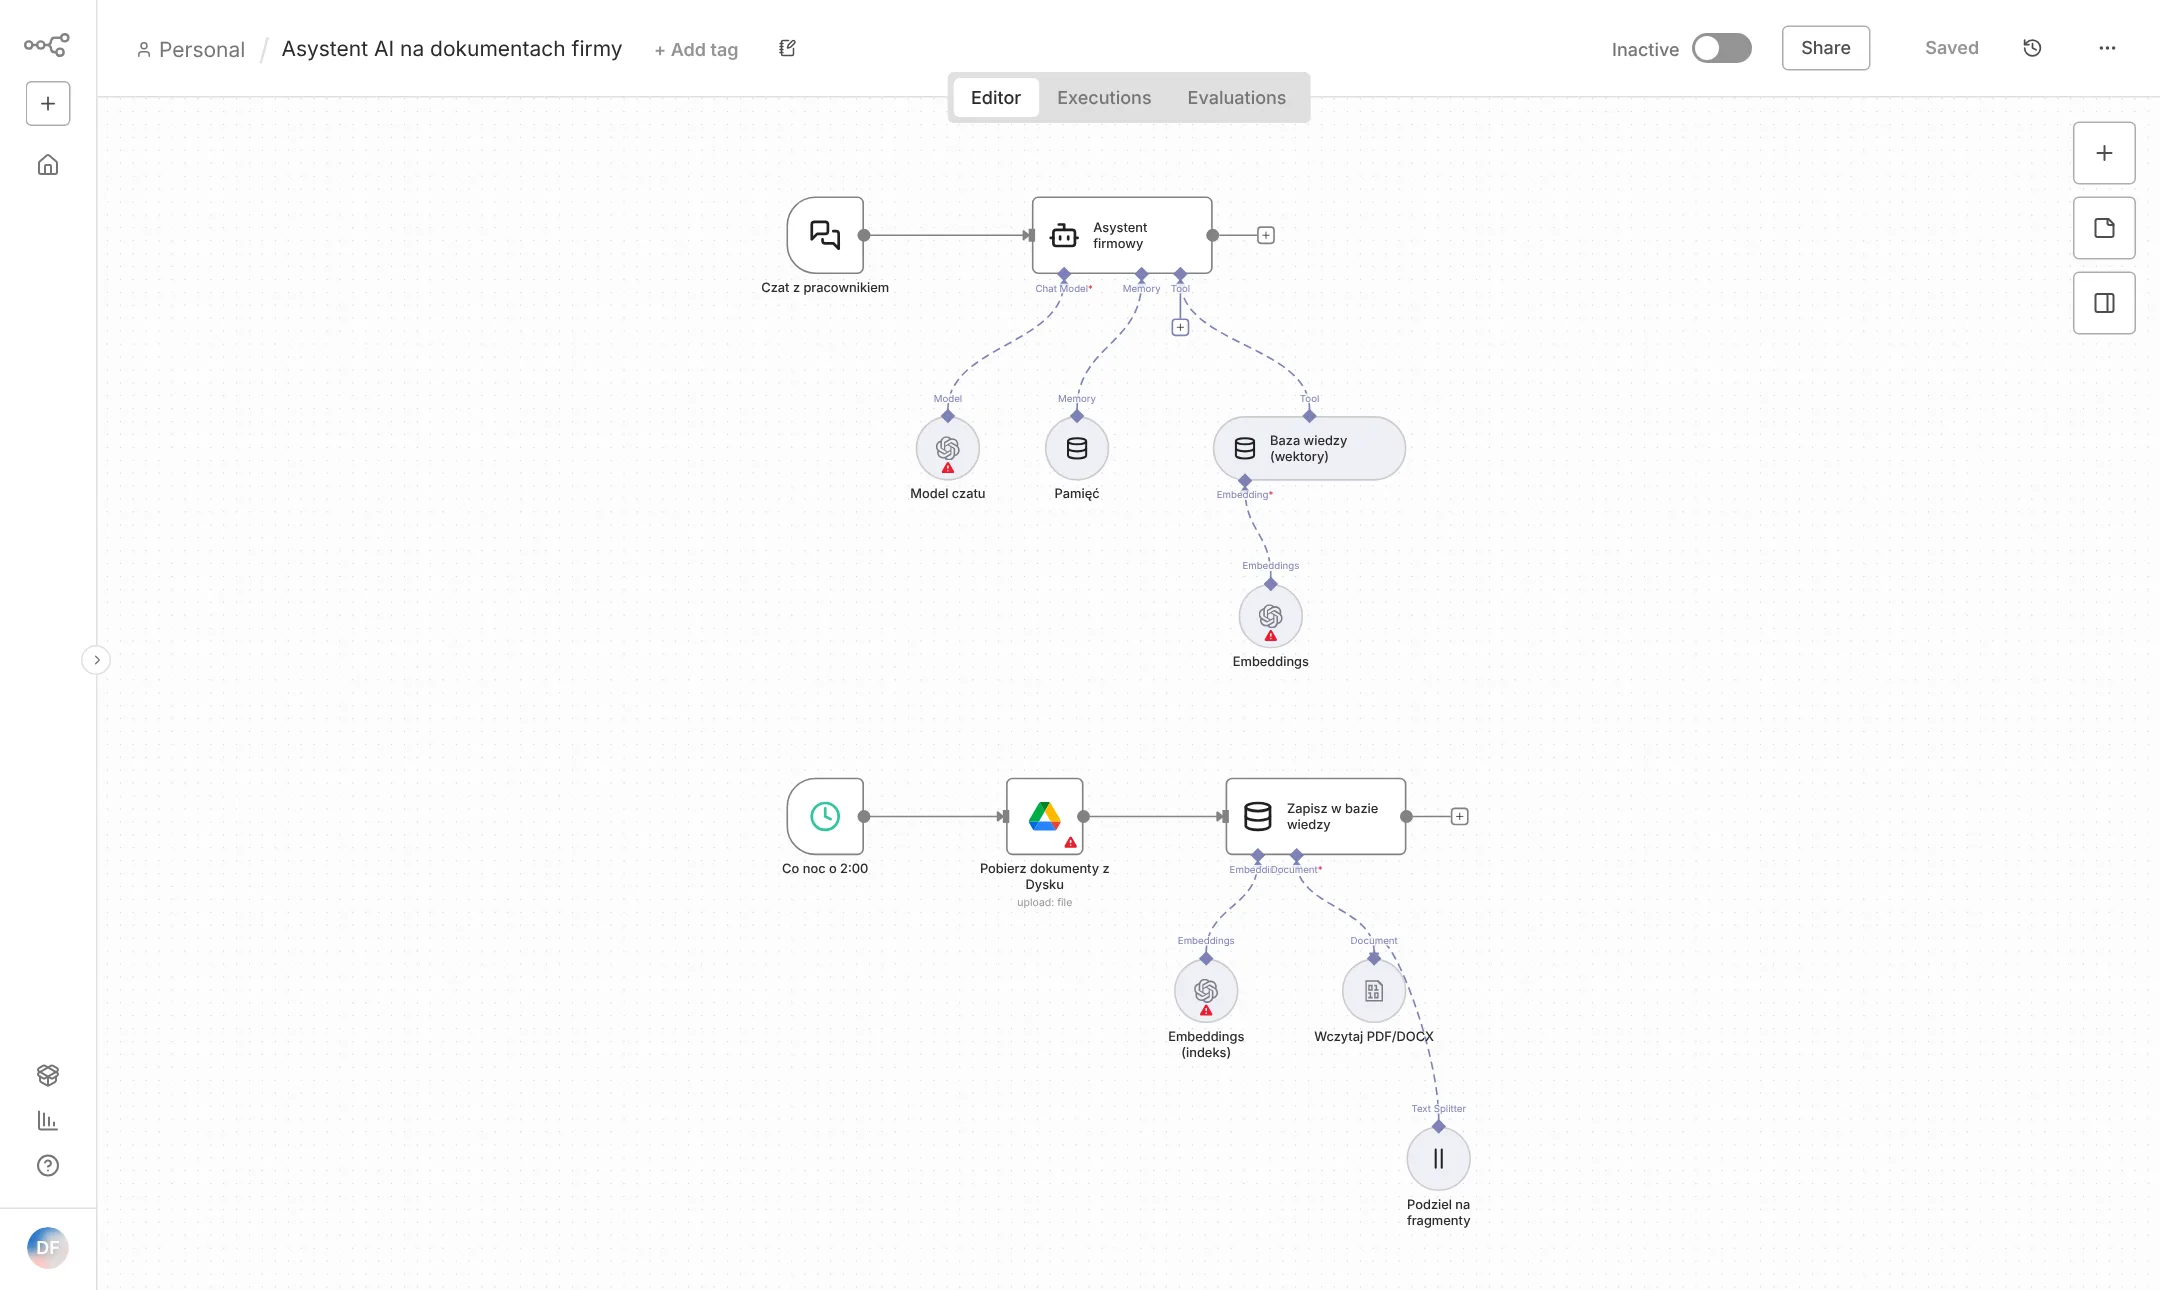
Ważny szczegół z dokumentacji n8n: do zapisu i do wyszukiwania trzeba użyć tego samego modelu embeddings. Jeśli zmienisz model, całą bazę trzeba zbudować od nowa. Wbudowany prosty magazyn wektorów n8n (Simple Vector Store) trzyma dane tylko w pamięci, traci je po restarcie i według dokumentacji nadaje się do testów, a nie do pracy produkcyjnej. Do firmy wybieram trwałą bazę, np. PostgreSQL z rozszerzeniem pgvector, Qdrant albo Supabase, które n8n obsługuje gotowymi węzłami.
Co musisz przygotować po stronie firmy
Asystent jest tak dobry jak dokumenty, które dostanie. To tu, a nie w technologii, najczęściej rozstrzyga się, czy projekt się uda.
- Jeden folder źródłowy. Asystent czyta tylko to, co jest w ustalonym miejscu, np. w folderze „Baza wiedzy” na dysku firmowym. Nie „cały dysk”.
- Jedna aktualna wersja dokumentu. Jeśli w folderze leżą „Cennik 2025” i „Cennik 2026 FINAL”, asystent może zacytować stary. Archiwum przenieś poza folder źródłowy.
- Pliki z tekstem, a nie skany. Zeskanowany PDF bez warstwy tekstowej trzeba najpierw przepuścić przez OCR, inaczej asystent go nie przeczyta.
- Czytelne nagłówki. Dokument z rozdziałami „Zwroty”, „Gwarancja”, „Dostawa” dzieli się na lepsze fragmenty niż jedna ściana tekstu.
- Właściciel treści. Konkretna osoba odpowiada za to, że procedury w folderze są aktualne.
- Lista 30–50 prawdziwych pytań. Zbierz je od pracowników przed startem. Posłużą do testów.
Na dysku kadrowa widzi umowy pracowników, a handlowiec nie. W bazie wektorowej wszystkie fragmenty leżą razem. Jeśli asystent ma odpowiadać różnym działom, trzeba to zaprojektować: osobne bazy albo filtrowanie fragmentów po metadanych, np. „dział: sprzedaż”. Najprościej zacząć od dokumentów, które może czytać każdy pracownik.
Wdrożenie krok po kroku
- Wybierz jeden obszar na pilotaż
Na przykład obsługę klienta (warunki dostawy, zwroty, gwarancja) albo wdrożenie nowych pracowników (procedury, instrukcje). Jeden obszar to 20–100 dokumentów, które da się przejrzeć ręcznie.
- Uporządkuj dokumenty
Usuń duplikaty i stare wersje, zrób OCR skanów, nadaj plikom nazwy, które coś mówią. To zwykle najdłuższy etap i nikt go za Ciebie nie zrobi lepiej niż osoba znająca firmę.
- Zdecyduj, gdzie działa przepływ i który model go obsługuje
n8n w chmurze producenta albo na własnym serwerze, model przez API (np. OpenAI), baza wektorowa. Przy danych wrażliwych ustal, gdzie fizycznie są przetwarzane. Wybór platformy opisuję w tekście n8n, Make czy Zapier.
- Zbuduj indeksowanie
Pobieranie plików z folderu, podział na fragmenty z zakładką (część tekstu powtarza się na granicy fragmentów, żeby nie ucinać zdań), dopisanie metadanych: nazwa pliku, data, dział. Odświeżanie zaplanuj co noc albo po zmianie pliku.
- Napisz zasady dla asystenta
Tak zwany prompt systemowy. U mnie zawsze zawiera: odpowiadaj tylko na podstawie przekazanych fragmentów, podawaj nazwę dokumentu, jeśli odpowiedzi nie ma, napisz to wprost i wskaż osobę do kontaktu, nie podawaj cen, których nie ma w cenniku.
Jesteś asystentem pracowników firmy. Odpowiadasz wyłącznie na podstawie fragmentów dokumentów z narzędzia "Baza wiedzy". Na końcu odpowiedzi podaj nazwy dokumentów, z których korzystałeś. Jeśli fragmenty nie zawierają odpowiedzi, napisz: "Nie znalazłem tego w dokumentach firmy" i zaproponuj kontakt z działem obsługi. Nie zgaduj cen, terminów ani warunków umów. - Przetestuj na prawdziwych pytaniach
Przepuść przez asystenta listę 30–50 pytań i oceń każdą odpowiedź: poprawna, częściowo poprawna, błędna, „nie wiem” słusznie albo niesłusznie. Błędne odpowiedzi prawie zawsze wynikają z dokumentów (brak, sprzeczność, stara wersja) albo z podziału na fragmenty. Popraw i powtórz test.
- Pilotaż z kilkoma osobami
Daj dostęp 3–5 pracownikom na 2–4 tygodnie. Zbieraj pytania, na które asystent nie odpowiedział. To gotowa lista braków w dokumentacji firmy.
- Ustal utrzymanie
Kto dodaje nowe dokumenty, kto sprawdza raz w miesiącu logi i koszty, co robimy, gdy dostawca modelu wycofa używany model. Bez tego asystent po pół roku odpowiada według starych procedur.
Ile kosztuje firmowy asystent AI
Koszt składa się z czterech części. Tylko jedna z nich zależy od liczby pytań.
| Składnik | Jak się płaci | Od czego zależy |
|---|---|---|
| Przygotowanie i budowa | Jednorazowo | Liczba i stan dokumentów, liczba źródeł (dysk, SharePoint, system firmowy), uprawnienia, miejsce, w którym pracownicy zadają pytania |
| Platforma automatyzacji | Miesięcznie | n8n w chmurze producenta (plany według liczby wykonań) albo własny serwer. Aktualne plany zestawiam w porównaniu platform |
| Model AI i embeddings przez API | Za zużycie (tokeny) | Liczba pytań, długość przekazanych fragmentów, wybrany model |
| Baza wektorowa i utrzymanie | Miesięcznie | Własna baza na serwerze albo usługa w chmurze, czas na aktualizacje i kontrolę jakości |
Przykład obliczeniowy kosztu API
Ceny z oficjalnego cennika OpenAI API, stan na 10 listopada 2026, poziom Standard, za milion tokenów:
| Model | Wejście | Wejście z pamięci podręcznej | Wyjście |
|---|---|---|---|
| gpt-6-luna | 0,10 USD | 0,01 USD | 0,50 USD |
| gpt-6.1-terra | 1,00 USD | 0,05 USD | 5,00 USD |
| gpt-6-astra | 10,00 USD | 1,00 USD | 50,00 USD |
| text-embedding-3-small (embeddings) | 0,02 USD | – | – |
Założenia przykładu, nie dane z konkretnej firmy: 20 pracowników zadaje średnio po 10 pytań dziennie przez 21 dni roboczych, czyli 4200 pytań miesięcznie. Każde pytanie to około 8000 tokenów wejścia (zasady, historia rozmowy i 5 fragmentów dokumentów) i 600 tokenów odpowiedzi. Daje to 33,6 mln tokenów wejścia i 2,52 mln tokenów wyjścia miesięcznie.
Wnioski z tego przykładu, które potwierdzają się w praktyce:
- Embeddings są prawie darmowe. Zaindeksowanie kilku tysięcy stron to ułamek dolara.
- Model decyduje o rachunku. Do odpowiedzi z procedur zwykle wystarcza model średni, a często tani. Najmocniejszy model ma sens przy trudnych dokumentach, np. umowach, i warto go testować na tej samej liście pytań.
- Długość kontekstu ma znaczenie. Przekazywanie 15 fragmentów zamiast 5 to trzy razy wyższy koszt wejścia, a często gorsza odpowiedź.
- Przetwarzanie w Europie kosztuje więcej. OpenAI oferuje rezydencję danych w Europie dla kwalifikujących się klientów API: ustawia się ją przy tworzeniu nowego projektu, a istniejącego projektu nie da się przestawić (informacja OpenAI o rezydencji danych w Europie). Według cennika API zapytania przez regionalne punkty końcowe kosztują 10% więcej w przypadku modeli wydanych od 5 marca 2026.
Alternatywą dla własnej bazy wektorowej jest gotowe narzędzie wyszukiwania w plikach po stronie dostawcy modelu. W cenniku OpenAI (stan na 10 listopada 2026) to 2,50 USD za 1000 wywołań narzędzia i 0,10 USD za GB dziennie przechowywania, z 1 GB bez opłat. Mniej budowania, ale dokumenty leżą u dostawcy, a Ty masz mniejszy wpływ na podział i filtrowanie.
Błąd w przepływie, np. pętla, która pyta model w kółko, potrafi zużyć miesięczny budżet w kilka godzin. W panelu dostawcy API ustaw limit wydatków i powiadomienie e-mailem, a w n8n ogranicz liczbę wiadomości na rozmowę.
Dane, bezpieczeństwo i RODO
Asystent wysyła fragmenty Twoich dokumentów do dostawcy modelu. Zanim wrzucisz do bazy umowy czy dane klientów, sprawdź te punkty:
- Trenowanie na danych. Według dokumentacji OpenAI o kontroli danych w API dane przesyłane przez API domyślnie nie służą do trenowania modeli. Dziennik nadużyć jest przechowywany do 30 dni, chyba że uzyskasz zgodę na inne ustawienia retencji.
- Umowa powierzenia. Jeśli w dokumentach są dane osobowe, dostawca modelu przetwarza je w Twoim imieniu. Potrzebna jest umowa powierzenia przetwarzania i wpis w rejestrze czynności. Szczegóły ustala inspektor ochrony danych albo prawnik.
- Minimalizacja. Do bazy wiedzy wrzucaj procedury, cenniki i instrukcje. Umowy z danymi osobowymi, kadry i dane zdrowotne zostaw poza nią, dopóki nie masz przemyślanych uprawnień.
- Dostęp do czatu. Czat asystenta nie może być publicznym adresem bez logowania. W n8n wyzwalacz czatu można zabezpieczyć uwierzytelnianiem albo osadzić za logowaniem w panelu firmowym.
- Zasady dla pracowników. Co wolno wklejać do czatu, a czego nie. Gotowy wzór znajdziesz w tekście polityka korzystania z AI w firmie.
O szerszych zagrożeniach piszę we wpisie AI a cyberbezpieczeństwo firmowe. Interpretację przepisów RODO w Twojej sytuacji zawsze potwierdza prawnik.
Najczęstsze błędy
- „Podłączmy cały dysk”. Asystent znajduje wtedy stare wersje, robocze notatki i pliki, których część pracowników nie powinna widzieć.
- Brak testów przed startem. Pierwsze złe odpowiedzi zniechęcają ludzi na długo. Lepiej opóźnić start o tydzień.
- Asystent bez prawa do „nie wiem”. Jeśli zasady tego nie przewidują, model chętnie dopowie coś prawdopodobnego.
- Brak właściciela treści. Technicznie wszystko działa, ale po kwartale odpowiedzi opierają się na nieaktualnym cenniku.
- Testowy magazyn wektorów w produkcji. Po restarcie serwera baza wiedzy jest pusta, a nikt tego nie zauważa.
Hurtownia z kilkunastoma handlowcami ma procedury reklamacji, warunki dostaw i karty techniczne produktów w kilkuset plikach. Nowi handlowcy przez pierwsze miesiące dzwonią do kierownika z tymi samymi pytaniami. Pilotaż obejmuje tylko reklamacje i dostawy: około 40 dokumentów, po czyszczeniu 25. Test na 40 pytaniach pokazuje, że błędne odpowiedzi biorą się z dwóch sprzecznych wersji procedury reklamacji. Po ich ujednoliceniu asystent odpowiada poprawnie na zdecydowaną większość pytań, a na resztę mówi, że nie znalazł odpowiedzi. Lista tych pytań trafia do kierownika jako plan uzupełnienia dokumentacji.
Kiedy lepiej to zlecić
Jeśli masz kilkanaście dokumentów i jeden plan firmowy ChatGPT, Copilot albo Gemini, spróbuj najpierw wbudowanych funkcji pracy z plikami. Własne wdrożenie warto zlecić, gdy:
- dokumentów są setki i zmieniają się co tydzień,
- źródeł jest kilka: dysk, system firmowy, baza produktów,
- różne działy mają widzieć różne dokumenty,
- odpowiedzi mają trafiać do komunikatora, panelu firmowego albo do klientów,
- potrzebujesz kontroli kosztów, logów i miejsca przetwarzania danych.
Takie przepływy buduję w ramach usługi automatyzacji procesów w firmie: od uporządkowania dokumentów, przez budowę i testy, po utrzymanie.
Chcesz, żeby pracownicy dostawali odpowiedzi z Waszych dokumentów?
Opisz, jakie dokumenty macie i kto najczęściej o nie pyta. Zaproponuję zakres pilotażu, platformę i model, a wycenę dostajesz przed rozpoczęciem pracy. Pracuję zdalnie w całej Polsce, a w Sieradzu i okolicach mogę przyjechać.
Najczęstsze pytania
Czy asystent AI uczy się na dokumentach mojej firmy?
Nie w sensie trenowania modelu. Dokumenty są dzielone na fragmenty i zapisywane w bazie wektorowej. Przy każdym pytaniu system wyszukuje kilka pasujących fragmentów i przekazuje je modelowi do przeczytania. Model pozostaje taki sam, a Ty możesz w każdej chwili usunąć dokument z bazy.
Ile kosztuje API przy firmowym asystencie AI?
W przykładzie z 4200 pytaniami miesięcznie koszt API według cennika OpenAI ze stanu na 10 listopada 2026 wynosi od około 4,62 USD dla modelu gpt-6-luna do około 462 USD dla gpt-6-astra. Zaindeksowanie dokumentów to ułamek dolara. Większą część budżetu stanowią przygotowanie dokumentów, budowa i utrzymanie.
Czy asystent może się pomylić?
Tak. Najczęściej myli się, gdy dokumenty są sprzeczne, nieaktualne albo źle podzielone na fragmenty. Dlatego asystent powinien podawać źródło, mieć prawo odpowiedzieć „nie znalazłem tego w dokumentach”, a przed startem przejść test na kilkudziesięciu prawdziwych pytaniach.
Czy dane z dokumentów trafiają do OpenAI?
Tak, fragmenty potrzebne do odpowiedzi są przesyłane do dostawcy modelu. Według OpenAI dane z API domyślnie nie są używane do trenowania modeli, a dziennik nadużyć jest przechowywany do 30 dni. Przy danych osobowych potrzebna jest umowa powierzenia, a dane szczególnie wrażliwe najlepiej zostawić poza bazą wiedzy.
Czy zamiast budować własnego asystenta wystarczy ChatGPT z plikami?
Przy kilkunastu stałych dokumentach często tak. Własny asystent ma przewagę, gdy dokumentów jest dużo, zmieniają się regularnie, pobierane są automatycznie z dysku firmowego, różne działy mają widzieć różne treści, a odpowiedzi mają trafiać do komunikatora lub panelu firmowego.
Powiązane wpisy


